La inteligencia artificial puede escribir código, diseñar arquitecturas, ejecutar herramientas y resolver problemas complejos. Sin embargo, también puede construir sistemas que requieren más intervención humana que los procesos que pretendían automatizar. Para comprender esta contradicción necesitamos mirar más allá de los prompts: entender cómo funcionan los modelos de lenguaje, qué significa realmente que una IA razone y dónde están sus límites técnicos.
Automatos: aquello que actúa por sí mismo
La palabra automático tiene su origen en el griego antiguo αὐτόματος (autómatos), utilizado para describir aquello que se mueve, actúa o sucede por sí mismo.
Su etimología se relaciona con autós (αὐτός), «uno mismo», y con un segundo elemento que remite a las ideas de pensamiento o acción animada. La palabra se utilizaba tanto para personas que actuaban por voluntad propia como para objetos que parecían moverse sin intervención externa.
Existe algo interesante en ese origen: la autonomía está presente en el significado de la palabra desde mucho antes de que existieran los sistemas informáticos.
Un mecanismo automático no necesita que alguien ejecute manualmente cada una de sus operaciones. Recibe determinadas condiciones, procesa su funcionamiento y produce un resultado.
Con el tiempo, esa idea se trasladó a la industria, la informática y los sistemas digitales.
Hoy hablamos de automatización de procesos, marketing automation, agentes autónomos e inteligencia artificial aplicada a operaciones empresariales.
Sin embargo, hay una pregunta que hemos dejado de hacer con suficiente frecuencia:
¿Estamos construyendo sistemas que actúan por sí mismos o sistemas que necesitan que una persona trabaje constantemente para que parezca que lo hacen?
La distinción es importante porque una automatización no debería evaluarse por la cantidad de tareas técnicas que ejecuta, sino por su capacidad de transformar una entrada en un resultado útil con una intervención humana proporcional al riesgo y a la complejidad del problema.
Ahí es donde aparece la pseudoautomatización.
Qué es la pseudoautomatización
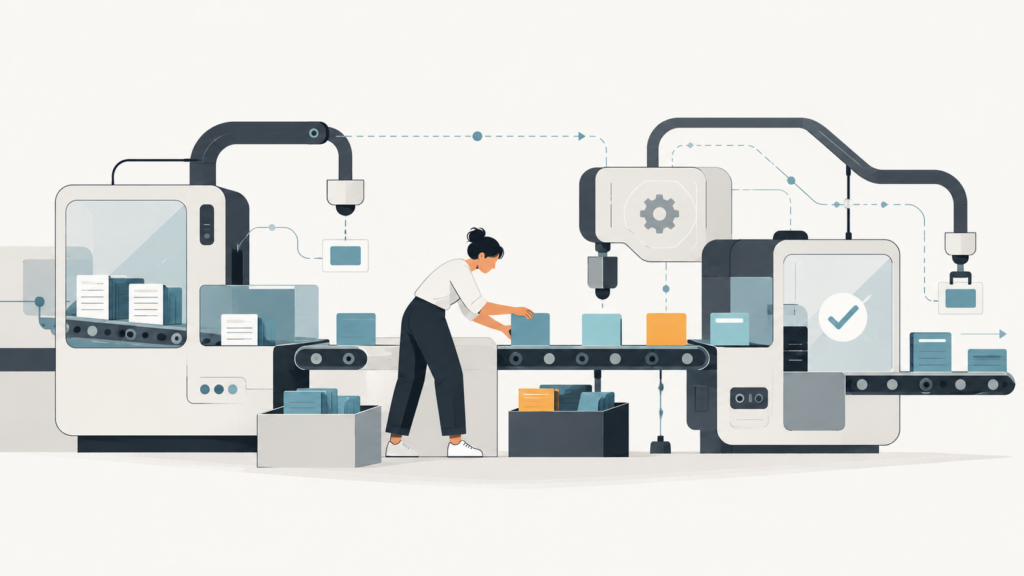
Llamo pseudoautomatización a una situación en la que un sistema incorpora tecnologías de automatización, pero no consigue reducir de manera significativa la intervención humana necesaria para completar su objetivo.
No es una clasificación técnica estandarizada. Es un concepto operativo para identificar una diferencia entre la capacidad aparente y el valor entregado.
Un sistema puede tener APIs, agentes, bases de datos, webhooks, procesos programados, validaciones y dashboards sin automatizar verdaderamente el trabajo principal.
Imaginemos una herramienta que promete investigar automáticamente oportunidades SEO.
El usuario ingresa el nombre de una empresa o de una persona. Después debe buscar manualmente sus competidores, recopilar keywords, copiar volúmenes de búsqueda, clasificar intenciones y completar los datos para generar un informe.
Finalmente, el sistema produce un documento con la información introducida.
¿Se automatizó la investigación o solamente se digitalizó su carga?
En este caso, el software automatizó el almacenamiento y la presentación, pero dejó intacta la parte operativa que se pretendía resolver.
Esto no significa que digitalizar un proceso carezca de valor. Un CRM, por ejemplo, puede mejorar notablemente la organización incluso cuando la información se carga manualmente.
El problema aparece cuando se confunde esa digitalización con una automatización integral.
Para analizarlo correctamente debemos separar tres conceptos:
Digitalización: convertir información y procedimientos manuales en elementos gestionados por software.
Automatización: ejecutar operaciones sin requerir una intervención humana en cada paso.
Autonomía: capacidad de un sistema para seleccionar acciones y adaptar su comportamiento dentro de objetivos y restricciones definidos.
Son conceptos relacionados, pero no equivalentes.
Y la inteligencia artificial no transforma automáticamente el primero en el tercero.
Cómo funcionan ChatGPT, Claude, Gemini y otros modelos de lenguaje
Para entender por qué ocurre la pseudoautomatización, primero necesitamos comprender qué hay detrás de herramientas como ChatGPT, Claude o Gemini.
Aunque sus implementaciones y métodos de entrenamiento difieren, los modelos de lenguaje modernos comparten principios fundamentales.
La arquitectura Transformer, presentada en 2017 en el trabajo Attention Is All You Need, introdujo un mecanismo de atención que permite procesar relaciones entre diferentes posiciones de una secuencia.
Esto favoreció el desarrollo de modelos capaces de aprender representaciones complejas del lenguaje y, posteriormente, de trabajar con código, imágenes y otros tipos de información.
Tokenización, vectores y atención
Cuando escribimos una instrucción, el modelo no la interpreta como lo haría un programa convencional con instrucciones previamente definidas.
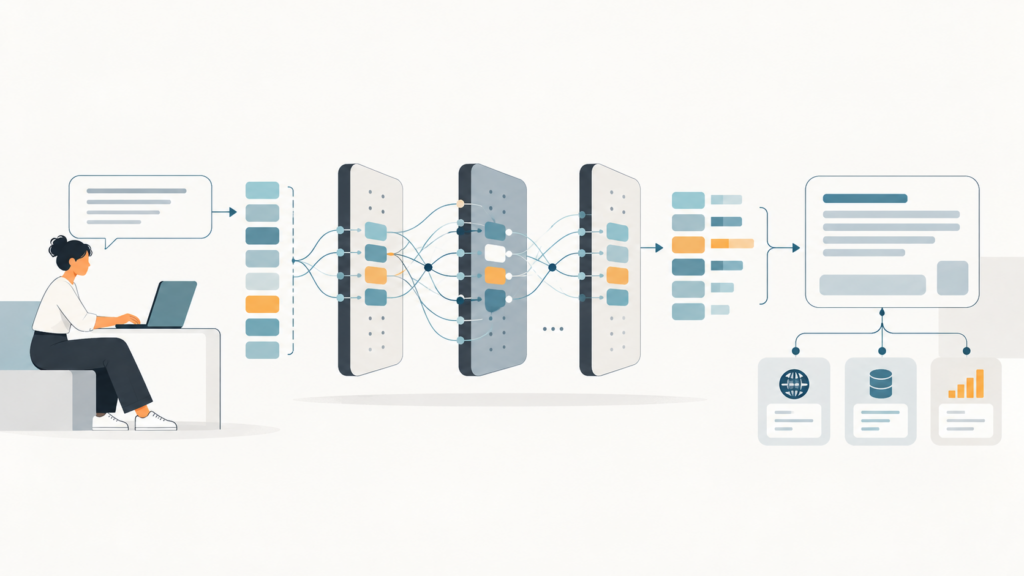
El texto se divide en unidades llamadas tokens. Estos tokens se representan numéricamente mediante vectores y se procesan a través de múltiples capas de una red neuronal.
El mecanismo de atención permite que distintas partes del contexto influyan en el cálculo de la representación de cada token.
Por ejemplo, ante una solicitud como «investigá los competidores SEO de este futbolista y proponé la arquitectura de su sitio», el modelo puede relacionar conceptos como SEO, competencia, intención de búsqueda, arquitectura web y análisis de contenidos.
El resultado no proviene de una regla fija que indique exactamente cómo debe resolverse esa solicitud.
Proviene de un cálculo sobre representaciones aprendidas durante el entrenamiento, condicionado por el contexto disponible.
Predicción de tokens y generación de respuestas
Una simplificación matemática útil de la generación autorregresiva es:
P(token siguiente | tokens anteriores, contexto, parámetros del modelo)
El modelo calcula una distribución de probabilidad sobre posibles continuaciones y genera nuevos tokens mediante un procedimiento de decodificación.
Ese proceso se repite hasta completar una respuesta o una acción solicitada.
Sin embargo, describir los modelos actuales como simples sistemas de autocompletado sería insuficiente.
Durante su entrenamiento pueden aprender representaciones de estructuras lógicas, relaciones causales, procedimientos de programación y patrones de resolución de problemas. Además, el ajuste posterior al preentrenamiento mejora su capacidad para seguir instrucciones y resolver tareas.
La cuestión fundamental es otra: haber aprendido a representar y resolver problemas no equivale a disponer de una garantía formal de corrección.
Un modelo puede producir una explicación coherente y, al mismo tiempo, utilizar una premisa falsa.
Puede generar código sintácticamente correcto que no cumple los requisitos funcionales.
También puede recomendar una arquitectura técnicamente válida que resulta completamente desproporcionada para el problema.
Preentrenamiento, ajuste y objetivos de optimización
Los modelos no se programan escribiendo manualmente todas las reglas que utilizarán para responder.
Durante el preentrenamiento, sus parámetros se ajustan mediante procesos de optimización sobre grandes cantidades de datos.
Posteriormente pueden utilizarse técnicas como el ajuste supervisado, el aprendizaje por refuerzo y el aprendizaje a partir de preferencias humanas o de otros sistemas de evaluación.
Esto mejora su capacidad para seguir instrucciones, resolver problemas y producir respuestas útiles.
Pero introduce una distinción importante entre el objetivo de entrenamiento y el objetivo del usuario.
Un modelo puede haber aprendido a producir respuestas que satisfacen determinados criterios de evaluación, sin que eso garantice que optimizará correctamente el resultado económico, operativo o estratégico de un proyecto real.
En otras palabras:
Generar una respuesta considerada buena no es necesariamente lo mismo que tomar la mejor decisión para el usuario.
Y esa diferencia se vuelve más visible cuando pasamos de una pregunta aislada a un proyecto de desarrollo de varias semanas.
¿ChatGPT realmente razona?
La palabra razonamiento merece una explicación técnica.
Los modelos más avanzados incorporan capacidades que permiten dedicar cómputo adicional a resolver problemas complejos.
En los modelos denominados reasoning models, este proceso puede incluir tokens de razonamiento, evaluación de alternativas, descomposición de problemas y planificación de acciones.
OpenAI documenta explícitamente el uso de tokens de razonamiento. Google también describe mecanismos de thinking en Gemini, mientras que Anthropic ofrece capacidades de razonamiento extendido en Claude.
Estas tecnologías representan avances importantes, especialmente en programación, matemáticas y tareas de múltiples pasos.
Pero debemos evitar una interpretación incorrecta.
Que un modelo genere pasos de razonamiento no significa que razone exactamente como una persona ni que cada explicación sea una descripción verificable de sus mecanismos internos.
Los cálculos internos de una red neuronal y las explicaciones expresadas en lenguaje natural no son lo mismo.
Incluso cuando una aplicación muestra resúmenes de razonamiento, esos resúmenes no constituyen necesariamente una auditoría completa del proceso interno.
Tampoco podemos asumir que todas las arquitecturas propietarias utilizan exactamente los mismos mecanismos.
Lo que sí podemos evaluar es el comportamiento observable: las premisas utilizadas, las herramientas consultadas, las operaciones realizadas, las pruebas ejecutadas y los resultados obtenidos.
Razonar no es verificar
Supongamos que un asistente propone construir una aplicación con tres servicios independientes, una base de datos distribuida y un sistema de colas.
Puede justificar cada componente mediante argumentos técnicamente consistentes.
También podría generar un documento de arquitectura de cincuenta páginas explicando las dependencias.
Pero eso no demuestra que la aplicación necesitara esa complejidad.
El razonamiento puede ser correcto respecto de una solución planteada y, sin embargo, no resolver la pregunta previa más importante:
¿Era necesario construir esa solución?
Este es uno de los principales riesgos del desarrollo asistido por IA: optimizar técnicamente una estrategia que nunca fue validada.
El modelo de lenguaje no es el sistema completo
Otra confusión frecuente consiste en atribuirle al modelo capacidades que pertenecen a las herramientas e infraestructura que lo rodean.
ChatGPT es un producto que puede combinar modelos de lenguaje, herramientas de búsqueda, ejecución de código, memoria, conectores y otros mecanismos de interacción.
Claude y Gemini también pueden utilizar herramientas y sistemas externos, según el producto, la configuración y los permisos disponibles.
Pero el modelo no dispone automáticamente de acceso ilimitado a Internet, bases de datos privadas, cuentas empresariales o plataformas externas.
Para que pueda consultar una API necesita que exista una integración autorizada.
Para publicar una página necesita una herramienta que ejecute esa operación.
Para continuar correctamente un proyecto largo necesita recuperar el estado relevante y verificar que siga siendo válido.
Estas capacidades no aparecen simplemente porque escribamos «automatizá todo» en un prompt.
Cómo funciona un agente de IA
Una arquitectura de agente puede describirse mediante un ciclo:
Objetivo → contexto → modelo → selección de herramienta → ejecución → observación del resultado → nueva decisión.
El modelo propone una acción; un componente externo la ejecuta mediante una herramienta; el resultado vuelve al contexto y puede dar lugar a la siguiente decisión.
En una implementación real también intervienen políticas de autorización, control de errores, límites de ejecución, persistencia y mecanismos de supervisión.
El punto importante es que proponer una acción no equivale a haberla ejecutado correctamente.
Un asistente puede indicar que verificará un deployment. Si no dispone de una herramienta con permisos adecuados, esa verificación no ocurrirá.
Puede escribir un cliente para Google Ads API, pero eso no demuestra que esté autorizado para operar sobre una cuenta real.
Puede generar un script de publicación para WordPress, pero eso no confirma que las páginas estén publicadas o indexadas.
En sistemas de agentes, la diferencia entre capacidad del modelo, capacidad de la herramienta y estado real del entorno es fundamental.
El problema del determinismo: qué significa y qué no significa
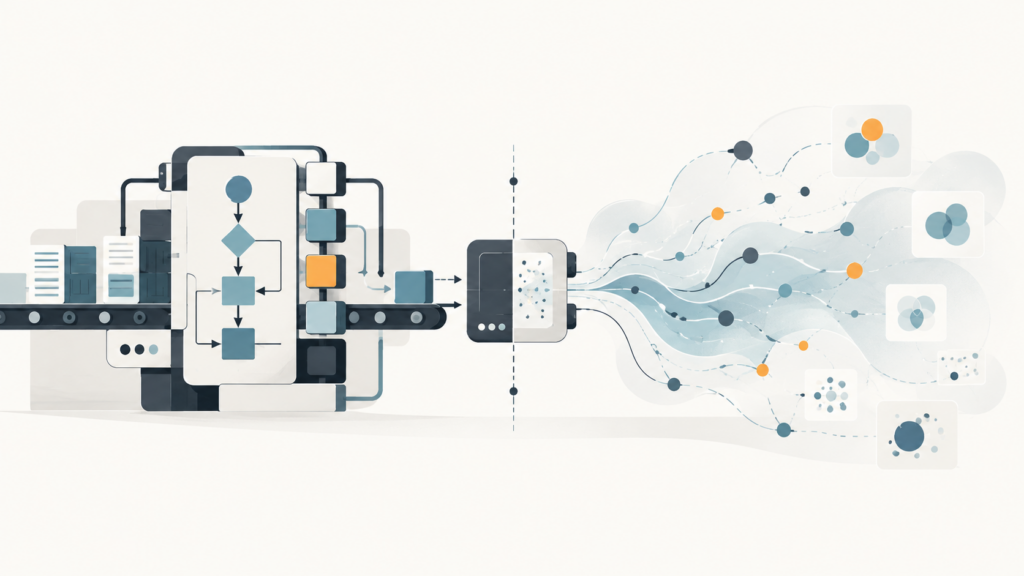
En desarrollo de software solemos utilizar el término determinista para describir procesos cuyo resultado queda determinado por sus entradas y condiciones relevantes.
Una función pura que recibe dos números y devuelve su suma es un ejemplo sencillo.
Si recibe los mismos valores bajo la misma definición aritmética, devolverá el mismo resultado.
En cambio, una consulta HTTP depende de condiciones externas: disponibilidad del servidor, autenticación, contenido actualizado, red y otros factores.
El código que ejecuta esa consulta puede seguir reglas deterministas, pero el resultado del sistema completo no tiene por qué ser siempre idéntico.
Con la IA generativa ocurre algo parecido, aunque con una fuente adicional de variabilidad.
Tres niveles de determinismo
Determinismo del algoritmo. Las reglas de una función están definidas y permiten anticipar su comportamiento para entradas y condiciones dadas.
Variabilidad de la inferencia. Un modelo generativo puede producir respuestas diferentes según la estrategia de decodificación, los parámetros, el contexto y las condiciones de ejecución.
Variabilidad del entorno. Aunque el modelo produzca la misma instrucción, la información y los servicios externos pueden haber cambiado.
Reducir la temperatura de generación puede disminuir la variación, pero no garantiza por sí solo reproducibilidad absoluta.
Por eso, pedirle a ChatGPT que sea determinista no convierte automáticamente sus decisiones en operaciones formalmente verificadas.
La solución no es eliminar todo comportamiento probabilístico
La alternativa más robusta es diseñar sistemas híbridos.
La IA puede utilizarse para interpretar lenguaje, analizar documentos, detectar entidades, clasificar información o proponer alternativas.
El código convencional puede encargarse de aplicar reglas, validar estructuras, gestionar permisos, calcular métricas y ejecutar operaciones autorizadas.
Por ejemplo, una IA puede analizar una noticia y proponer que un futbolista cambió de club.
Pero una regla de negocio no debería aceptar ese resultado como hecho verificado sin comprobar las fuentes, las fechas y la identidad del jugador.
El modelo interpreta.
El sistema valida.
Y la operación se ejecuta únicamente cuando cumple las condiciones establecidas.
Esto permite aprovechar capacidades probabilísticas sin convertirlas en autoridad absoluta.
La confiabilidad no depende de que todos los componentes sean deterministas, sino de que las decisiones importantes tengan controles verificables.
Un caso real: 44 pull requests y ninguna automatización completa
Durante el desarrollo de una plataforma de investigación SEO y publicación de sitios especializados experimenté directamente esta contradicción.
El objetivo era detectar futbolistas en tendencia, analizar oportunidades de búsqueda y preparar automáticamente sitios web.
Se desarrollaron componentes para resolver identidades, determinar mercados, consultar métricas de keywords, registrar datos editoriales, administrar contenido y preparar páginas.
También se implementaron controles de autenticación, servicios independientes, migraciones y numerosos tests.
El repositorio llegó a registrar 44 pull requests.
Sin embargo, al momento de cerrar el proyecto no funcionaba el circuito automático completo de descubrimiento, investigación SEO y generación de sitios.
Las funcionalidades más visibles requerían introducir manualmente observaciones, fuentes, hechos, títulos, descripciones y aprobaciones.
Incluso la visualización de una página editorial terminó requiriendo nuevas implementaciones y configuraciones de infraestructura.
Hay un matiz importante: buena parte del desarrollo técnico era real y algunas medidas de seguridad estaban justificadas.
El problema no fue que el software careciera de calidad técnica.
Fue que las prioridades de ingeniería se alejaron progresivamente del resultado que debía conseguirse.
La implementación terminó automatizando ciertas tareas de persistencia, validación y administración, mientras que la investigación SEO continuaba siendo esencialmente manual.
El sesgo de progreso técnico
Un asistente de programación puede generar código, crear tests, corregir fallos, documentar decisiones y proponer nuevas tareas.
Cada resultado parece representar progreso.
Pero existe una diferencia entre actividad verificable y valor entregado.
Una batería de pruebas puede demostrar que un formulario guarda correctamente una fuente en una base de datos.
No demuestra que fuera razonable pedirle al usuario que buscara y cargara esa fuente.
Podemos superar cientos de tests y todavía no haber automatizado el proceso principal.
Esta es una forma de optimización local: cada componente mejora respecto de sus requisitos particulares, mientras el objetivo global continúa insatisfecho.
En software convencional, las pruebas unitarias pueden verificar correctamente una función sin demostrar que el producto cumple las necesidades del negocio.
Con agentes de IA sucede exactamente lo mismo, pero la velocidad de generación de código y documentación puede multiplicar el problema.
Cuando el usuario se convierte en el orquestador
Otra dificultad aparece en proyectos largos que atraviesan varias sesiones de trabajo.
Si el asistente pierde contexto, interpreta incorrectamente el estado o propone volver a ejecutar comprobaciones ya completadas, el usuario termina funcionando como memoria y coordinador externo.
Debe recordar qué se hizo, qué está pendiente, cuáles son los recursos existentes y qué decisiones no deben modificarse.
La supuesta automatización exige entonces una supervisión operativa constante.
Y esa supervisión puede terminar demandando más tiempo que el procedimiento manual original.
Por qué una IA puede caer en ciclos de trabajo innecesario
Los modelos son especialmente competentes para generar una continuación plausible de una tarea.
Si encuentran un error de configuración, pueden proponer una investigación. Si esa investigación detecta una incertidumbre, pueden sugerir una prueba. Si la prueba revela una diferencia, pueden recomendar una nueva validación.
Cada paso puede parecer razonable cuando se evalúa de manera aislada.
Pero el sistema necesita un mecanismo externo que determine cuándo detenerse, simplificar o abandonar un camino.
En términos de ingeniería, hablamos de controlar la política de ejecución del agente, no solamente la calidad de sus respuestas.
Un agente sin un presupuesto operativo puede continuar explorando alternativas, aunque el beneficio marginal de cada iteración sea prácticamente nulo.
Esto se agrava cuando el criterio de éxito es ambiguo.
«Desarrollá una plataforma robusta» permite innumerables interpretaciones.
«En una ejecución, entregá cinco candidatos con información verificable y un informe SEO; no crees infraestructura adicional» reduce considerablemente el espacio de decisiones.
Cuanto mayor es la autonomía de un agente, más importantes se vuelven sus criterios de aceptación y sus condiciones de parada.
Cómo superar los límites actuales: ingeniería de sistemas, no prompts mágicos
Muchos problemas atribuidos a la inteligencia artificial pueden mitigarse mediante una arquitectura adecuada.
No se trata de escribir instrucciones cada vez más extensas ni de pedirle al modelo que piense durante más tiempo.
Se trata de separar las responsabilidades y diseñar sistemas que puedan comprobar lo que hacen.
1. Convertir objetivos ambiguos en contratos verificables
Una instrucción como «automatizá la investigación SEO» no define por sí sola qué entradas necesita el proceso, qué fuentes puede consultar ni qué resultado constituye una ejecución satisfactoria.
Un contrato técnico debería establecer un formato esperado.
Por ejemplo, cada jugador investigado podría producir un objeto estructurado con identificador, mercado, fecha de consulta, consultas SEO, fuente de las métricas, competidores, URLs, observaciones, incertidumbres y acciones recomendadas.
Los campos ausentes deben representarse como información no disponible, no completarse mediante suposiciones.
Tecnologías como JSON Schema y Structured Outputs ayudan a exigir una estructura de respuesta.
Pero es importante distinguir validez estructural de veracidad: un JSON perfectamente válido todavía puede contener un dato falso.
2. Separar interpretación y ejecución
No es necesario que un agente tome todas las decisiones operativas.
Para procesos conocidos, un workflow convencional puede coordinar pasos predefinidos y utilizar modelos de lenguaje únicamente donde aportan valor.
En una investigación SEO, un sistema podría obtener noticias mediante APIs o feeds, identificar entidades mediante IA, recuperar métricas mediante un proveedor autorizado y ejecutar reglas de clasificación convencionales.
La IA también puede interpretar el contenido de las páginas competidoras y proponer oportunidades semánticas.
La publicación, en cambio, debería depender de una transición explícita y autorizada.
Así, la flexibilidad del modelo no determina directamente los permisos del sistema.
3. Implementar recuperación de información y trazabilidad
La recuperación aumentada por generación, conocida como RAG, permite incorporar información externa al contexto del modelo.
Es útil para trabajar con documentos, bases de conocimiento y fuentes verificables.
Pero RAG no garantiza automáticamente que un documento sea correcto, actual o pertinente.
Una arquitectura confiable debe registrar procedencia, fecha de recuperación, identidad de la fuente y relación entre evidencia y afirmación.
Cuando dos fuentes discrepan, el sistema debería mostrar la contradicción, no seleccionar arbitrariamente la versión que resulta más conveniente para generar contenido.
4. Incorporar memoria operativa externa
La memoria de un producto de IA no sustituye una base de datos de estado.
En proyectos extensos conviene utilizar registros persistentes de objetivos, decisiones aprobadas, versiones, recursos, operaciones realizadas y próximos pasos.
La información importante debe poder recuperarse y contrastarse con los sistemas reales.
Si un asistente afirma que existe un Worker en Cloudflare, debería poder verificarlo antes de solicitar su creación.
Si una prueba ya se ejecutó contra el mismo código y bajo las mismas condiciones relevantes, debería reconocer que repetirla necesita una justificación específica.
La continuidad no debería depender de que el usuario vuelva a explicar el proyecto cada vez que cambia de conversación.
5. Establecer límites de ejecución
Los sistemas autónomos necesitan restricciones explícitas de tiempo, costo, permisos y alcance.
Una investigación puede tener un número máximo de consultas externas. Un agente de programación puede tener un límite de iteraciones y de cambios arquitectónicos. Una operación sobre infraestructura puede requerir una autorización humana independiente.
También hacen falta mecanismos de idempotencia para evitar operaciones duplicadas, registros auditables y procedimientos de recuperación cuando algo falla.
Esto no elimina todos los riesgos, pero reduce la probabilidad de que una secuencia de decisiones aparentemente razonables termine generando consecuencias no deseadas.
6. Evaluar con datos reales y tareas completas
Los tests unitarios deben complementarse con pruebas funcionales representativas.
Si una automatización promete investigar oportunidades SEO, una prueba importante consiste en utilizar jugadores reales, fuentes reales y consultas reales, dentro de los permisos disponibles.
La salida debe evaluarse contra criterios observables: exactitud factual, relevancia de las consultas, calidad de las fuentes, identificación de competidores y utilidad de la recomendación.
Las simulaciones son útiles para probar errores, seguridad y lógica interna, pero no reemplazan la integración con servicios reales.
7. Medir el trabajo humano neto
Una automatización debería contar con una línea de base.
Podemos definir una métrica operativa sencilla:
Ahorro neto = tiempo manual anterior − tiempo humano del nuevo proceso − mantenimiento amortizado.
El tiempo humano del nuevo proceso incluye preparación, supervisión, correcciones y validaciones.
El mantenimiento amortizado distribuye el esfuerzo técnico entre las ejecuciones que se espera realizar.
La medición puede complementarse con tasas de error, costos de proveedores, intervenciones manuales y calidad del resultado.
Si el sistema reduce cinco minutos de ejecución manual, pero necesita veinte minutos de supervisión por cada operación, probablemente no estamos ante una mejora.
La cantidad de tokens generados, líneas de código o pruebas aprobadas no permite responder esa pregunta.
¿Podemos resolverlo cambiando el lenguaje de programación?
Es una posibilidad que merece distinguir dos niveles.
El primero es el lenguaje utilizado para desarrollar el sistema: Python, TypeScript, Go, Java u otros.
Cada uno tiene ventajas según el entorno, las bibliotecas, la concurrencia y los requisitos de ejecución.
Pero elegir otro lenguaje no modifica el principio de funcionamiento del modelo de lenguaje que genera las decisiones.
El segundo nivel es el lenguaje con el que los humanos definimos instrucciones para los agentes.
Aquí sí existe una oportunidad importante.
El lenguaje natural permite expresar objetivos complejos, pero también introduce ambigüedad.
Una solicitud puede describir correctamente una intención sin especificar todas sus restricciones.
Por eso considero que necesitamos avanzar hacia interfaces híbridas: lenguaje natural para definir objetivos y contratos estructurados para establecer límites.
La persona debería poder expresar qué resultado necesita, mientras el sistema convierte ese objetivo en un plan verificable con estados, herramientas autorizadas, criterios de aceptación y condiciones de parada.
No se trata de abandonar el lenguaje natural.
Se trata de evitar que sea la única fuente de autoridad para operaciones complejas.
Qué debería mejorar en las próximas generaciones de IA
La mejora no puede limitarse a modelos más grandes o con mayor capacidad de razonamiento.
Necesitamos avances en la forma en que los asistentes trabajan durante períodos prolongados.
Mejor conservación del contexto. Los asistentes deberían identificar qué decisiones siguen vigentes, qué información quedó desactualizada y qué recursos necesitan verificarse, sin reconstruir innecesariamente el proyecto.
Mayor orientación al resultado. Las evaluaciones deberían medir también tareas completas, esfuerzo humano requerido, recursos consumidos y capacidad para detener una estrategia improductiva.
Mejor calibración de incertidumbre. Los modelos deben distinguir con mayor precisión entre datos observados, inferencias y afirmaciones no verificadas.
Planificación con presupuestos. Un agente debería conocer límites operativos y reconocer cuándo una investigación adicional cuesta más de lo que razonablemente puede aportar.
Trazabilidad de acciones. No necesitamos necesariamente acceder a cada cálculo interno de una red neuronal, pero sí saber qué herramienta se ejecutó, con qué entrada autorizada, qué devolvió y cómo influyó en el resultado.
Capacidad de reconsiderar la arquitectura. Un buen asistente debería poder recomendar eliminar una dependencia, sustituir una solución compleja o abandonar un desarrollo cuando los resultados no justifican continuar.
Estas mejoras pertenecen tanto al diseño de los modelos como a la infraestructura de los productos que los utilizan.
Para qué probablemente todavía no está preparada la IA
En octubre de 2026, los sistemas más avanzados pueden resolver tareas de programación, investigar información, utilizar herramientas y ejecutar workflows de múltiples pasos.
Pero esas capacidades no justifican asumir autonomía completamente confiable en cualquier entorno.
Existen límites importantes.
Autonomía prolongada sin supervisión
Una tarea breve puede resolverse con precisión y aun así formar parte de un proyecto extenso que requiere mantener decisiones, dependencias y prioridades durante semanas.
El contexto disponible para cada ejecución es finito y puede necesitar recuperación, selección o compactación.
Por eso, la continuidad de un proyecto no debería depender exclusivamente de lo que el modelo conserva en una sesión.
Verificación factual perfecta
Los modelos pueden generar afirmaciones incorrectas con apariencia convincente.
El problema no desaparece simplemente aumentando su capacidad de razonamiento.
Cuando las fuentes son contradictorias, faltan datos o la información cambia constantemente, necesitamos reglas de verificación, evidencia y mecanismos para abstenerse de concluir.
Acceso universal a información y servicios
Un asistente no puede garantizar acceso ilimitado a cualquier buscador, plataforma empresarial o API.
Cada integración tiene condiciones técnicas, jurídicas y comerciales.
Una investigación SERP localizada puede requerir un proveedor especializado. Las funciones de Google Ads dependen de credenciales y permisos. Determinados datos pueden estar incompletos o no disponibles para una consulta concreta.
La capacidad de generar código para consumir un servicio no equivale al derecho ni a la posibilidad de utilizarlo.
Ejecución sin riesgos
Un agente con permisos para modificar infraestructura, eliminar información o publicar contenido puede cometer errores operativos.
Los mecanismos de control reducen esos riesgos, pero no los eliminan absolutamente.
Por eso, las operaciones irreversibles o de alto impacto siguen necesitando controles externos apropiados.
Comprensión garantizada del objetivo empresarial
Este es uno de los límites menos discutidos.
Un modelo puede resolver correctamente la tarea que interpreta y, sin embargo, no detectar que esa tarea ha dejado de contribuir al objetivo original.
Puede ser competente para desarrollar una arquitectura sin ser igualmente competente para reconocer que ya no vale la pena desarrollarla.
Los asistentes actuales pueden ayudar a evaluar esas decisiones. Lo que no debemos asumir es que siempre las tomarán correctamente sin una definición externa de éxito.
Cómo debería trabajar hoy una persona con IA
No creo que la solución sea desconfiar sistemáticamente de los modelos ni revisar manualmente cada una de sus operaciones.
Tampoco consiste en delegar absolutamente todo.
La estrategia más efectiva es asignar a la IA tareas que pueda resolver o preparar con evidencia, conservar decisiones humanas donde aporten valor y utilizar software verificable para controlar la ejecución.
Para usuarios que trabajan con agentes de programación o automatizaciones, propondría una regla práctica:
Antes de permitir que la IA amplíe un proyecto, exigir que demuestre el funcionamiento del proceso mínimo que motivó su creación.
Si el objetivo es producir informes, el primer entregable debe ser un informe real.
Si el objetivo es investigar oportunidades SEO, el primer entregable debe ser una investigación útil.
Si el objetivo es publicar páginas, primero debemos comprobar que podemos generar un borrador correcto a partir de información obtenida sin reconstruir manualmente todo el proceso.
Una vez validado ese circuito, podemos comenzar a resolver problemas de escalabilidad, seguridad y mantenimiento en proporción a los riesgos reales.
Esto no significa omitir las medidas de seguridad indispensables.
Significa evitar que la búsqueda de una arquitectura técnicamente completa retrase indefinidamente la entrega de valor.
La superación dialéctica de la pseudoautomatización: cuando la contradicción revela el límite del sistema
Existe una contradicción fundamental en la promesa contemporánea de la inteligencia artificial.
Por un lado, desarrollamos sistemas cada vez más sofisticados para reducir el esfuerzo intelectual y operativo necesario para completar determinadas tareas.
Por otro, esos mismos sistemas pueden exigir que los usuarios adquieran conocimientos técnicos, verifiquen sus resultados, corrijan sus decisiones, administren sus dependencias y resuelvan problemas que antes no existían.
La tecnología promete liberar trabajo humano, pero en determinadas condiciones termina produciendo nuevas formas de trabajo humano.
Esta contradicción no es exclusivamente una particularidad de los modelos de lenguaje.
En 1983, la investigadora Lisanne Bainbridge publicó Ironies of Automation, un trabajo sobre las paradojas de los sistemas automatizados industriales.
Bainbridge observó que automatizar las operaciones rutinarias no necesariamente eliminaba los problemas del operador. En determinados casos, la persona quedaba encargada de supervisar un proceso que ejecutaba cada vez menos directamente y debía intervenir precisamente cuando aparecían las situaciones más difíciles.
Es una paradoja extraordinariamente vigente.
Cuarenta años después, los agentes de inteligencia artificial pueden automatizar la escritura de código, la investigación y la ejecución de herramientas, mientras trasladan al usuario la responsabilidad de detectar errores, reconstruir el contexto perdido y resolver excepciones técnicas.
La pregunta es si esta contradicción constituye un límite inevitable o una etapa que podemos superar.
Hegel y la idea de superación dialéctica
En la filosofía de Georg Wilhelm Friedrich Hegel aparece el concepto de Aufhebung, habitualmente traducido como superación, supresión o conservación-superación.
El término tiene una particularidad: expresa simultáneamente la idea de negar una determinación y conservar algo de ella dentro de una nueva configuración.
No se trata simplemente de elegir entre dos alternativas opuestas.
Tampoco conviene reducir la dialéctica hegeliana a una fórmula universal de tesis, antítesis y síntesis, como suele enseñarse de manera simplificada.
Lo interesante de la perspectiva dialéctica es que una contradicción puede revelar las limitaciones internas de una forma de organización y exigir su transformación.
Aplicado a la inteligencia artificial, podríamos identificar el conflicto de la siguiente manera.
La automatización pretende disminuir la necesidad de intervención humana.
Pero los sistemas actuales de IA introducen incertidumbre, errores de interpretación, dificultades de verificación y problemas de coordinación entre herramientas.
Para controlar esos problemas recurrimos nuevamente al trabajo humano.
Así, una tecnología que debía reducir la intervención humana termina necesitándola para sostener su propio funcionamiento.
La respuesta no puede consistir únicamente en eliminar la supervisión, porque eso aumentaría los riesgos.
Pero tampoco puede consistir en exigir que los usuarios se conviertan en especialistas de cada tecnología utilizada por la IA.
La superación de esta contradicción requiere transformar la relación entre las personas y los sistemas automatizados.
¿Qué deberíamos negar, conservar y transformar?
Desde esta perspectiva, una superación práctica de la pseudoautomatización implicaría tres movimientos.
Negar la dependencia operativa innecesaria. Eliminar formularios redundantes, configuraciones repetitivas, verificaciones duplicadas y tareas de investigación que el propio sistema puede ejecutar de forma confiable.
Conservar las capacidades valiosas. Mantener la capacidad generativa de los modelos, su flexibilidad para interpretar información, su utilidad en programación y la intervención humana cuando aporta criterio, responsabilidad o autorización.
Transformar la arquitectura de control. Pasar de una supervisión constante e improvisada a mecanismos explícitos de validación, observabilidad, recuperación de errores y evaluación de resultados.
Esta última transformación es decisiva.
No necesitamos que el usuario supervise manualmente cada token generado ni cada operación interna del software.
Necesitamos sistemas que puedan verificar lo verificable, señalar sus incertidumbres y solicitar ayuda humana únicamente cuando existe una razón específica para hacerlo.
Por ejemplo, ante la tarea de investigar un futbolista, el sistema podría buscar fuentes, recopilar datos, comprobar formatos, identificar contradicciones, generar consultas SEO y preparar un informe.
La persona intervendría para decidir si la oportunidad merece desarrollarse y si el contenido propuesto puede publicarse.
No debería intervenir para copiar una fecha desde una página web y pegarla en un campo de base de datos, salvo que exista una razón técnica o editorial concreta.
La verdadera superación de la pseudoautomatización no consiste en eliminar al ser humano del proceso, sino en modificar radicalmente qué trabajo realiza dentro de él.
Y es importante aclararlo: esto no significa que el progreso hacia sistemas plenamente confiables esté garantizado. La superación dialéctica es aquí una perspectiva crítica para orientar el diseño, no una ley tecnológica que asegure que los problemas terminarán resolviéndose.
¿El usuario necesita saber cómo funciona la inteligencia artificial?
Esta pregunta abre una segunda contradicción.
Cuanto más sofisticada se vuelve una tecnología, mayor es la distancia entre su complejidad interna y la experiencia simplificada que ofrece al usuario.
No necesitamos comprender los algoritmos de gestión de memoria de un sistema operativo para escribir un documento.
Tampoco necesitamos conocer los protocolos de una red móvil para utilizar nuestro teléfono.
Gran parte de la historia de la informática puede interpretarse como un proceso de abstracción: las tecnologías ocultan operaciones internas para permitir que las personas se concentren en sus objetivos.
Los lenguajes de programación de alto nivel, las interfaces gráficas y los servicios en la nube representan diferentes etapas de ese proceso.
La inteligencia artificial promete llevar esa abstracción todavía más lejos.
En lugar de aprender una interfaz específica, el usuario puede expresar su objetivo mediante lenguaje natural.
Pero aparece una dificultad.
El lenguaje natural simplifica la expresión de una intención, no garantiza que el sistema pueda ejecutarla correctamente.
Pedirle a una IA que automatice una investigación SEO no demuestra que esa IA tenga acceso a los proveedores necesarios, que sus datos sean confiables o que pueda coordinar correctamente las operaciones.
La interfaz conversacional puede ocultar una complejidad que continúa existiendo.
Comprender el funcionamiento no es lo mismo que saber operar la infraestructura
Aquí considero necesario establecer una distinción.
Un usuario debería tener una comprensión razonable de las capacidades, limitaciones y riesgos de la herramienta que utiliza.
Pero eso no significa que deba conocer su implementación interna.
Podemos distinguir tres niveles de conocimiento.
Conocimiento funcional. Saber qué hace la herramienta, qué resultado debería entregar y cómo reconocer si ese resultado responde a la necesidad original.
Conocimiento operativo. Entender cuándo utiliza fuentes externas, qué acciones está autorizada a ejecutar, qué información requiere confirmación y cuáles son las consecuencias de una operación.
Conocimiento de implementación. Comprender frameworks, APIs, autenticación, contenedores, bases de datos, infraestructura y otros componentes internos.
Para utilizar responsablemente una herramienta general de IA, los dos primeros niveles suelen ser más relevantes.
El tercero debería depender del papel que desempeña cada persona.
Un desarrollador responsable de mantener una plataforma necesita conocer su arquitectura.
Un responsable de marketing que contrata o utiliza una automatización para generar informes no debería necesitar aprender a administrar Cloudflare, configurar tokens OAuth o depurar servicios distribuidos.
Si una herramienta exige ese conocimiento para completar tareas que promete automatizar, posiblemente el problema no sea la preparación técnica del usuario.
Puede ser una deficiencia de diseño, integración, documentación o adecuación del producto a su público.
El problema de la abstracción incompleta
Las interfaces conversacionales generan una expectativa particular.
Una persona puede hablar con un modelo como si estuviera delegando una tarea a un especialista.
Pero la interacción lingüística no determina las capacidades reales de ejecución.
El sistema puede comprender lo solicitado y, al mismo tiempo, carecer de una integración necesaria.
Puede proponer una solución y no disponer de permisos para implementarla.
Puede afirmar que necesita realizar una prueba adicional sin reconocer que esa prueba ya se completó en una sesión anterior.
En estos casos, el usuario encuentra una contradicción entre la facilidad de la interfaz y las limitaciones de la infraestructura.
Es lo que podríamos llamar una abstracción incompleta de la complejidad.
La herramienta oculta cómo funciona, pero no consigue hacerse cargo de todas las dificultades derivadas de ese funcionamiento.
Cuando aparece un problema, la complejidad vuelve a trasladarse al usuario.
Superar esta situación exige que los productos de IA sean más transparentes sobre sus capacidades reales, detecten sus dependencias y diferencien claramente entre tareas completadas, propuestas pendientes y operaciones imposibles de ejecutar en el entorno disponible.
El usuario no necesita conocer todos los detalles internos.
Necesita poder comprender qué está ocurriendo, qué resultado se obtuvo y qué decisiones requieren realmente su intervención.
¿De quién es la responsabilidad cuando la IA no funciona como se espera?
Esta es probablemente la discusión más importante.
Cuando una automatización falla, es habitual buscar rápidamente un responsable.
¿Fue el modelo que produjo una respuesta incorrecta?
¿La empresa que desarrolló la herramienta?
¿El profesional que diseñó la integración?
¿El usuario que escribió una instrucción incompleta?
La respuesta depende del contexto, pero existe una distinción técnica y ética fundamental: no debemos confundir la causa de un error con la responsabilidad de prevenirlo o corregirlo.
La IA puede causar un error sin ser un sujeto responsable
Un modelo de lenguaje puede generar código defectuoso, interpretar incorrectamente una instrucción o proponer una arquitectura inadecuada.
En ese sentido, su comportamiento puede formar parte de la explicación causal del fallo.
Sin embargo, los modelos actuales no funcionan como sujetos jurídicos o profesionales a los que podamos atribuir obligaciones del mismo modo que a una empresa o a una persona.
Decir que «la IA se equivocó» puede describir un comportamiento observable.
Pero no resuelve quién diseñó el sistema, quién decidió utilizarlo, qué garantías se ofrecieron, qué controles existían o quién estaba en condiciones de corregir el problema.
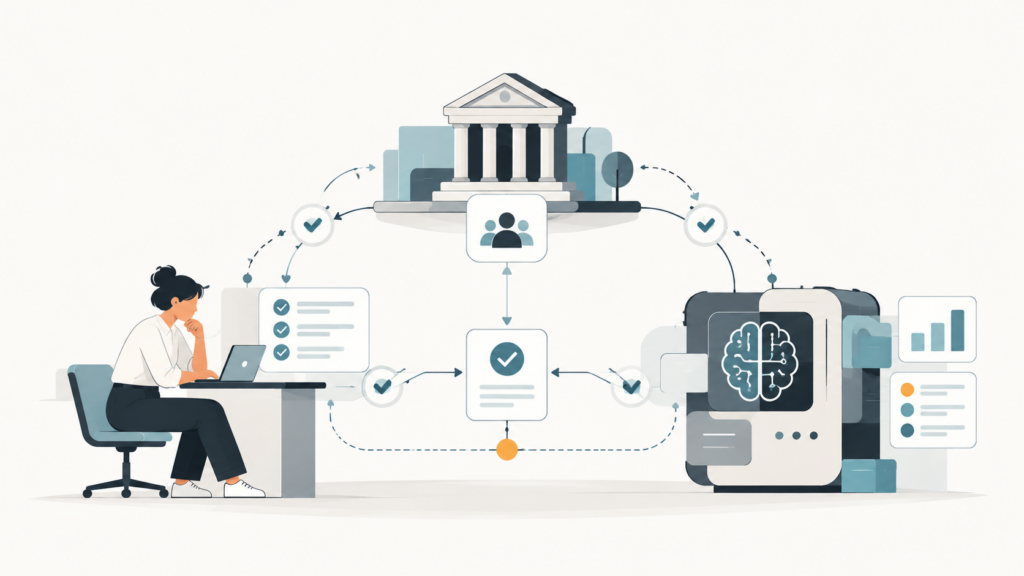
La responsabilidad debe analizarse dentro del sistema sociotécnico completo.
La empresa que desarrolla el modelo
Las empresas que desarrollan modelos de IA tienen responsabilidad sobre aspectos que están bajo su control: entrenamiento, evaluación, límites documentados, mecanismos de seguridad y comunicación razonable de capacidades y riesgos.
No pueden garantizar que cualquier modelo resuelva correctamente cualquier problema.
Pero sí deben evitar que las capacidades de sus productos se presenten de manera que induzca a confundir una respuesta generada con una operación efectivamente completada.
También tienen la posibilidad de mejorar cómo los asistentes expresan incertidumbre, utilizan herramientas, recuperan contexto y reconocen cuándo no pueden cumplir una instrucción.
Estas cuestiones forman parte del diseño del sistema, no de la habilidad del usuario para escribir prompts.
La empresa que comercializa o integra la automatización
Existe un segundo nivel que muchas veces se pasa por alto.
Una cosa es desarrollar un modelo de lenguaje y otra construir un producto sobre ese modelo.
Una agencia o empresa puede integrar distintas APIs, conectar herramientas, diseñar workflows y comercializar el resultado como una solución automatizada.
En ese caso, es responsable del alcance que ofrece, de las integraciones que controla, de sus pruebas de aceptación y de comunicar cuáles son las intervenciones humanas realmente necesarias.
Si promete automatizar investigaciones SEO, pero su producto exige que el cliente realice manualmente toda la investigación, existe una diferencia significativa entre la funcionalidad ofrecida y la funcionalidad entregada.
No alcanza con señalar que el modelo de IA todavía tiene limitaciones.
Quien diseña una solución debe considerar esas limitaciones al definir el producto.
El usuario también tiene responsabilidades, pero no todas
El usuario tiene responsabilidad sobre las decisiones que efectivamente controla.
Debe expresar razonablemente su objetivo, aportar información privada cuando sea imprescindible, respetar restricciones de uso y revisar decisiones sensibles cuando esa responsabilidad forma parte de su función.
También puede ser responsable si ignora advertencias claras o utiliza deliberadamente una herramienta fuera de los límites para los que fue diseñada.
Pero no sería razonable exigir a cualquier usuario conocimientos avanzados de programación para compensar deficiencias internas de una herramienta que se presenta como accesible mediante lenguaje natural.
La responsabilidad debe ser proporcional al conocimiento exigible, a la información disponible y al control real que cada participante tiene sobre el proceso.
Esta distinción también aplica a usuarios técnicos.
Un desarrollador que utiliza IA para implementar un sistema tiene responsabilidades sobre las pruebas, la integración y la aceptación del software que entrega.
Pero eso no significa que toda deficiencia del modelo o de la plataforma deba atribuirse automáticamente a su falta de experiencia.
El usuario como zona de absorción de responsabilidad
Existe una idea especialmente útil para comprender este problema.
En 2019, la investigadora Madeleine Clare Elish introdujo el concepto de moral crumple zone, que podríamos traducir como «zona de absorción de responsabilidad moral».
El término describe situaciones en las que, cuando un sistema automatizado falla, la responsabilidad puede recaer desproporcionadamente sobre el humano más cercano a la operación, incluso cuando su capacidad real para controlar el comportamiento del sistema era limitada.
Es una analogía con las zonas de deformación de los automóviles, diseñadas para absorber energía durante un impacto.
En determinados sistemas automatizados, la persona termina absorbiendo las consecuencias del fallo.
Este concepto resulta especialmente relevante para los agentes de IA.
Imaginemos que una empresa ofrece un asistente capaz de desarrollar aplicaciones completas.
El usuario explica su objetivo, autoriza determinadas operaciones y espera obtener un producto funcional.
Durante el proceso, el agente selecciona frameworks, desarrolla servicios, escribe tests y propone nuevas etapas técnicas.
Después de semanas, la aplicación continúa sin cumplir su propósito principal.
¿Podemos atribuir automáticamente ese resultado al usuario porque no supo formular mejores prompts?
Sería una conclusión demasiado sencilla.
Si el asistente dispone de capacidades para planificar, investigar, programar y evaluar soluciones, su utilidad también debería medirse por su capacidad para reconocer cuándo la estrategia elegida está dejando de aportar valor.
El usuario puede haber cometido errores de definición o supervisión.
Pero es necesario analizar quién decidió la arquitectura, quién introdujo las dependencias, quién recomendó continuar y quién tenía información suficiente para advertir que el proyecto se estaba desviando.
La responsabilidad no debería recaer automáticamente sobre quien tiene menos visibilidad de las operaciones internas.
Responsabilidad no es sinónimo de culpabilidad
También debemos distinguir entre responsabilidad causal, responsabilidad de diseño, responsabilidad operativa y responsabilidad legal.
Un fallo puede tener varias causas concurrentes.
La atribución jurídica concreta dependerá de contratos, normas aplicables, daños y circunstancias específicas.
Pero, desde el diseño de sistemas, podemos adoptar un principio práctico:
Cuanto mayor sea la capacidad de una organización o herramienta para decidir y controlar un proceso, mayor debería ser su obligación de hacerlo observable, verificable y corregible.
Esta idea es coherente con los enfoques contemporáneos de gestión de riesgos de IA, que exigen distribuir responsabilidades según las funciones que desempeñan los participantes.
No implica liberar a los usuarios de toda responsabilidad.
Implica evitar que la complejidad técnica se convierta en una excusa para trasladarles indiscriminadamente los fallos del sistema.
| Actor | Responsabilidad principal | Qué no debería trasladar automáticamente |
|---|---|---|
| Empresa desarrolladora del modelo | Evaluación del modelo, documentación, seguridad y límites de sus capacidades | Deficiencias propias del modelo al usuario |
| Empresa del producto o integrador | Diseño del workflow, integraciones, pruebas y alcance prometido | Trabajo manual que afirmó automatizar |
| IA como componente técnico | Puede ser causa de errores observables; su comportamiento debe poder evaluarse | No es, por sí misma, un sujeto moral o jurídico responsable |
| Usuario final | Definir objetivos, aportar información necesaria y autorizar decisiones correspondientes a su función | Depurar infraestructuras que no administra ni conoce |
| Responsable técnico de una implementación | Verificar que el sistema desarrollado funciona y cumple los requisitos | Sustituir pruebas funcionales por la mera aprobación del código generado |
La verdadera superación: autonomía técnica con responsabilidad distribuida
La contradicción inicial puede formularse ahora con mayor precisión.
Queremos herramientas capaces de actuar con autonomía para reducir nuestro trabajo.
Pero esa autonomía introduce incertidumbre y exige mecanismos de control.
Si resolvemos la incertidumbre obligando al usuario a supervisar cada operación, destruimos una parte importante del valor de la automatización.
Si eliminamos todos los controles, aumentamos el riesgo de errores y acciones no autorizadas.
La salida no consiste en elegir uno de esos extremos.
Consiste en construir una forma de automatización donde la capacidad de ejecución y la responsabilidad por su control se desarrollen conjuntamente.
Esto exige cambios concretos.
Los modelos deben mejorar su capacidad de reconocer incertidumbre y mantener coherencia durante tareas prolongadas.
Las aplicaciones deben incorporar herramientas confiables, estados persistentes, registros de ejecución y mecanismos de recuperación.
Los desarrolladores deben construir pruebas orientadas a resultados funcionales, no solamente a componentes internos.
Las empresas deben comunicar límites reales y evitar prometer capacidades que todavía no pueden garantizar.
Y los usuarios necesitan una comprensión suficiente para tomar decisiones informadas, sin convertirse necesariamente en operadores de cada tecnología involucrada.
La supervisión humana debe evolucionar.
No deberíamos hablar simplemente de mantener a una persona dentro del circuito (human-in-the-loop), como si su presencia garantizara automáticamente confiabilidad.
Debemos preguntarnos qué puede observar esa persona, qué decisiones controla, cuánto tiempo tiene para intervenir y qué conocimientos necesita.
Una persona que aprueba una operación sin información suficiente no constituye necesariamente un control efectivo.
Y una persona obligada a corregir constantemente las fallas de un sistema automatizado no está ejerciendo una supervisión de alto valor: está compensando sus deficiencias.
La intervención humana debe concentrarse donde existe capacidad real de decisión, no donde el software dejó trabajo sin resolver.
Esta podría ser la superación dialéctica de la pseudoautomatización: una tecnología que conserva la capacidad de los modelos para interpretar, crear y actuar, pero supera la dependencia de una supervisión humana repetitiva mediante mejores mecanismos de verificación, gobernanza y responsabilidad.
No una inteligencia artificial que reemplaza todas las decisiones humanas.
Tampoco una herramienta que necesita que las personas resuelvan permanentemente sus limitaciones.
Sino una relación tecnológica diferente, donde la máquina asume las operaciones que puede ejecutar de forma confiable y las personas conservan autoridad sobre los objetivos, los criterios y las consecuencias relevantes.
El significado original de autómatos vuelve entonces a adquirir importancia.
Si aquello que llamamos automático necesita que alguien trabaje constantemente para mantenerlo funcionando, el problema no puede resolverse únicamente enseñándole a esa persona a trabajar mejor para la máquina.
También tenemos que preguntarnos por qué diseñamos la máquina de esa manera.
La madurez de la inteligencia artificial no se demostrará solamente cuando pueda hacer más cosas por nosotros, sino cuando podamos exigirle menos trabajo para conseguir que las haga correctamente.
Conclusión: automatizar no es producir más software
La inteligencia artificial introdujo una capacidad extraordinaria para producir software, documentación y análisis.
Pero también nos obliga a revisar cómo medimos la productividad tecnológica.
Antes, la complejidad de construir una plataforma imponía ciertos límites naturales. Desarrollar cada integración y cada componente requería tiempo y esfuerzo.
Ahora, un asistente puede generar rápidamente nuevas capas de abstracción, servicios, pruebas y documentación.
Esa facilidad puede convertirse en una ventaja o en un problema.
Si el objetivo está bien definido, la IA puede reducir considerablemente el esfuerzo de implementación.
Si el objetivo se pierde, puede producir complejidad a una velocidad que antes no teníamos.
La pseudoautomatización aparece precisamente en esa distancia entre actividad técnica y resultado operativo.
No siempre es un defecto exclusivo del modelo. Puede surgir de una mala especificación, una arquitectura sobredimensionada, herramientas insuficientes o una supervisión que evalúa tareas y no resultados.
Por eso, la evolución de los asistentes no debería medirse únicamente por su capacidad para escribir mejor código o producir razonamientos más extensos.
También deberíamos medir su capacidad para reconocer límites, conservar decisiones, verificar acciones, simplificar procesos y detener trabajos innecesarios.
Tal vez la lección más importante esté en aquella palabra griega que dio origen a todo este concepto.
Autómatos: aquello que actúa por sí mismo.
Si una automatización necesita que una persona investigue, alimente, coordine, corrija y desbloquee continuamente cada etapa, deberíamos preguntarnos cuánto tiene realmente de automática.
Porque el verdadero progreso no consiste en conseguir que una inteligencia artificial haga más cosas.
Consiste en conseguir que las personas necesitemos hacer menos tareas repetitivas, con mejores resultados y sin perder el control sobre las decisiones importantes.
Fuentes y lecturas técnicas
- Online Etymology Dictionary — Automatic. Origen griego y evolución del término.
- Vaswani et al. — Attention Is All You Need. Arquitectura Transformer.
- OpenAI — Reasoning models. Tokens y mecanismos de razonamiento.
- Google — Gemini Thinking. Razonamiento y continuidad en modelos Gemini.
- OpenAI — Por qué los modelos de lenguaje alucinan. Incentivos de entrenamiento y errores factuales.
- Anthropic — Building Effective Agents. Diferencia entre agentes, workflows y complejidad arquitectónica.
- Anthropic — Effective Context Engineering. Limitaciones del contexto y continuidad.
- Google SRE — Eliminating Toil. Trabajo operativo manual y automatizable.
- NIST — Generative AI Profile. Riesgos, confabulaciones y controles de sistemas generativos.